


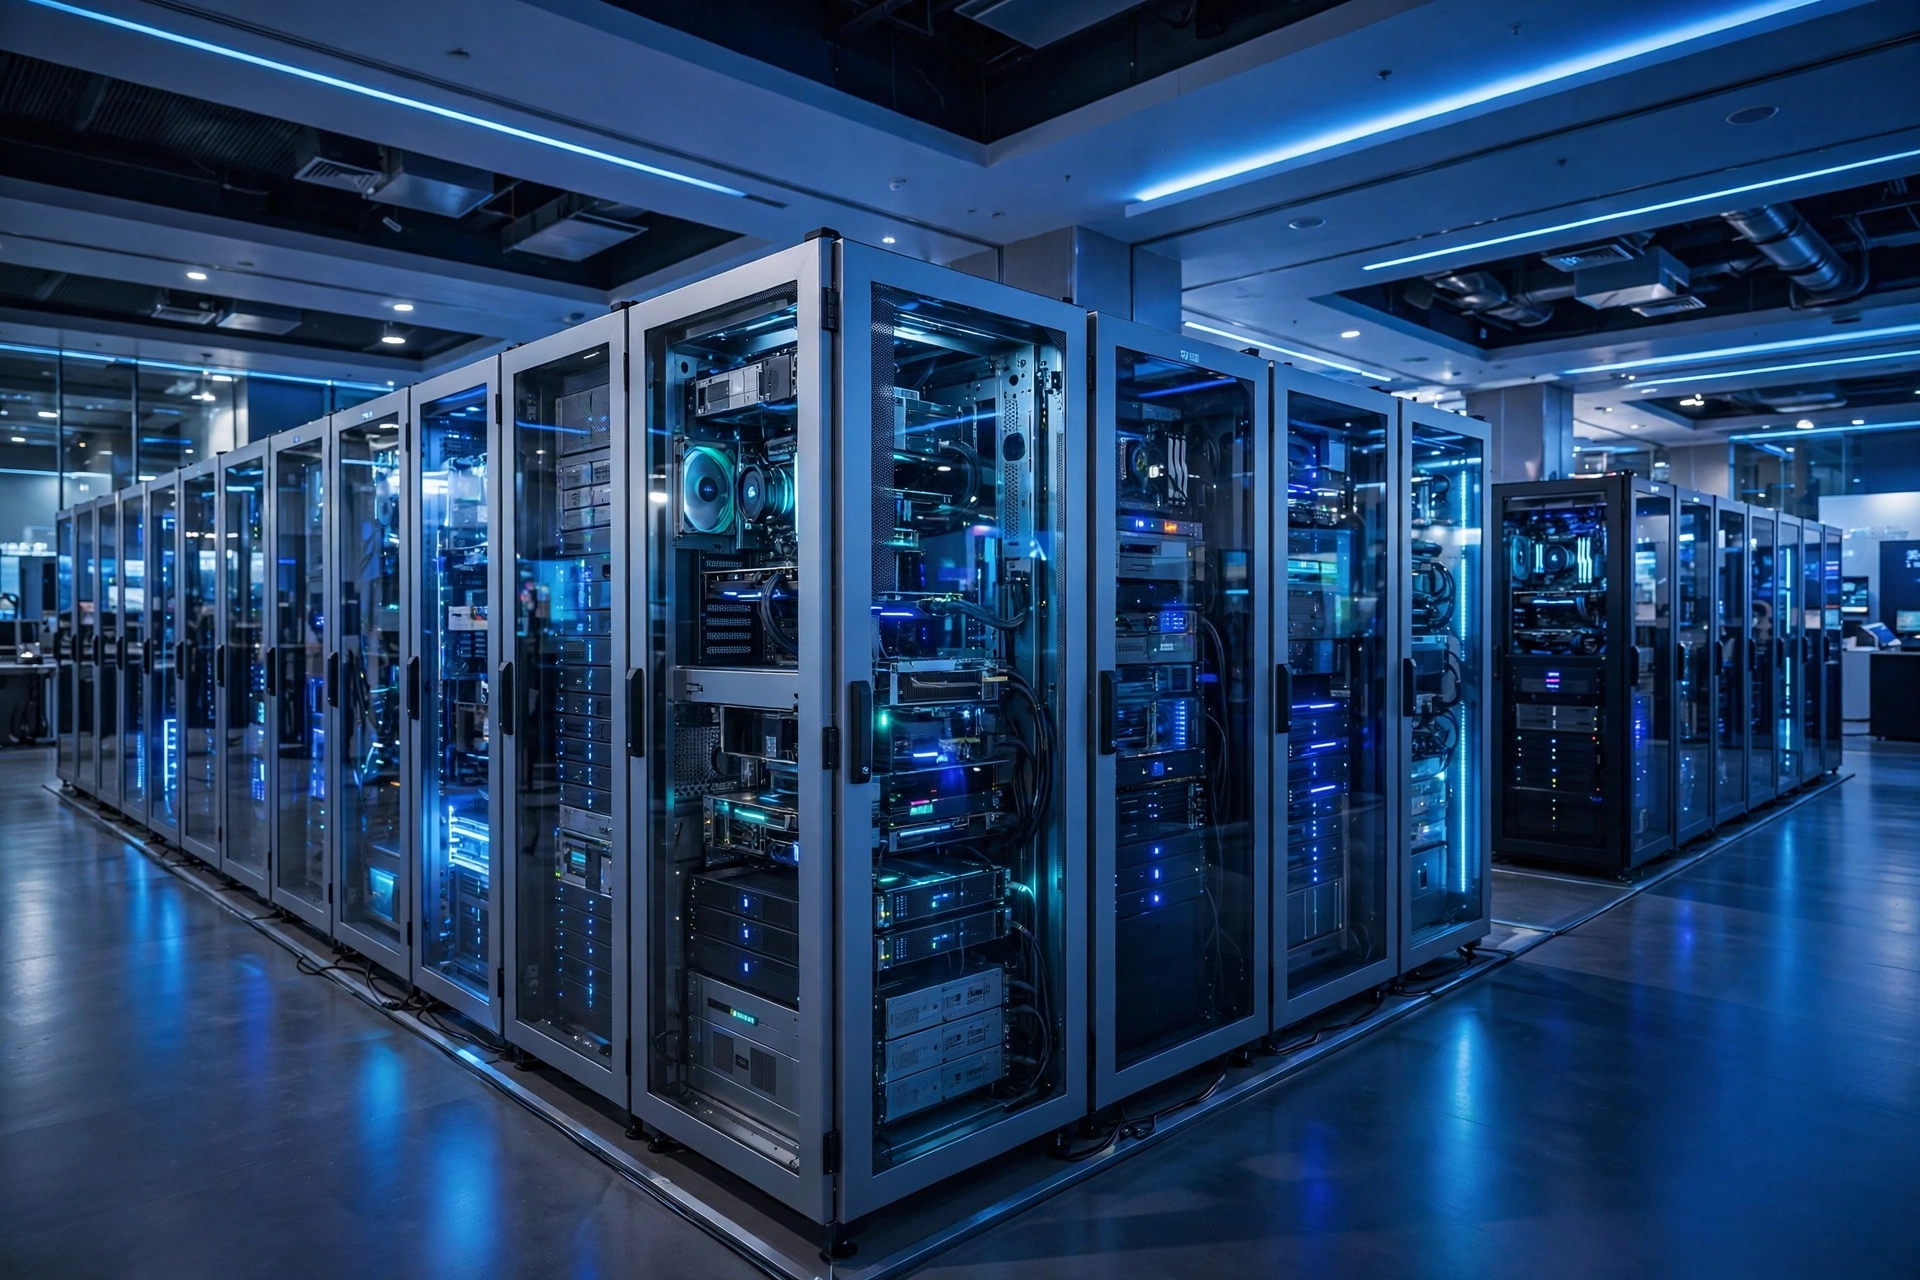
2026全国高性能计算学术大会在深圳开幕,一台重量级的“真机”成为全场焦点:我国首个全国产十万卡AI超集群正式亮相,并同步发布了十大应用成果。这意味着在算力这个事关科技自立自强的关键赛道上,我国又向前迈出了扎实一步——从核心芯片到整机系统,从底层架构到上层应用,这套超集群实现的是全链条的自主可控。
所谓“十万卡”,指的是这套超集群集成了十万张国产AI加速卡。这个规模有多大?在全球范围内,单体万卡规模的集群已经属于顶级算力基础设施,而一次性实现十万张国产加速卡的互联协同,其难度不仅在于硬件数量的堆叠,更在于如何让十万张卡像一个整体那样高效运转。互联网络的带宽与延迟、并行计算的效率、故障的自动隔离与恢复,每一项都是对工程能力的极限考验。这套系统的亮相,说明我国在超大规模集群的系统集成与调度优化上已经趟出了一条自己的路。
更值得关注的是这套系统的技术路线。由中科曙光推出的曙光8000系统,最大的特点是“超算与智算的原生融合”。过去,超级计算机和智能计算是两个相对独立的赛道:超算擅长高精度科学计算,比如天气预报、流体力学仿真、新药分子模拟;智算则专注于大模型的训练与推理。两者在架构、软件栈、任务调度上都有差异,很多科研机构不得不分别建设、分别运维。而曙光8000把二者做到了同一个底座上——同一套硬件和系统软件,既能跑传统的高精度科学计算任务,又能支撑大模型的训练和推理,资源可以在两种负载之间灵活调配。
这种融合带来的直接价值,是打通了科学研究的新范式。在大会上发布的应用成果展示了一条完整的科研闭环:先用仿真生成海量数据,再用AI模型快速筛选出有潜力的候选方案,最后用高精度计算对筛选结果进行复核验证。以新材料研发为例,传统方式是科研人员凭经验提出配方、再到实验室反复试错,周期长、成本高;新的闭环则是先通过物理仿真批量生成材料数据,用AI模型从中筛选出性能最优的候选组合,最后用高精度计算复核确认,大大缩短了从想法到成果的距离。这套“仿真数据生成—AI筛选—高精度复核”的流程,正是当前全球科学智能(AI for Science)浪潮中最受重视的方法论。
全国产的底色,则让这套系统有了更深远的战略意义。从加速卡芯片、高速互联网络,到操作系统、并行计算框架、AI训练框架,全栈采用国产技术路线,意味着在外部环境不确定的情况下,我国的尖端科研和大模型产业依然有一条可靠的算力底座可以依靠。近年来,全球AI算力竞争日趋激烈,高端算力芯片的供给时常受到地缘因素扰动。在这种背景下,十万卡规模的全国产集群从蓝图走进现实,无疑给国内的科研机构和AI企业吃下了一颗定心丸。
从应用层面看,十大应用成果的发布同样信息量十足。这些成果覆盖了科学计算与智能计算的多个交叉领域,既有面向基础科研的,也有直接服务产业的。它们的共同点在于:都不是纸面上的理论指标,而是已经在真实业务中跑通的案例。这说明超集群不只是一台“秀肌肉”的样机,而是已经具备了承接国家级科研任务和产业级大模型训练的能力。对于正在推进数字化转型的传统行业、正在冲击大模型高地的科技企业而言,这样一套算力基础设施的上线,意味着排队等算力的日子正在成为过去。
把视野放得更宽一些,这次亮相其实是中国算力版图加速成形的一个缩影。从“东数西算”工程的全面推进,到各地智算中心的密集落地,再到这次十万卡超集群的真机登场,我国正在构建一张多层次、广覆盖的算力网。而超算智算原生融合的技术路线,有可能成为下一代算力基础设施的主流方向:与其建两套系统分别运维,不如一套底座灵活调度,既省钱又高效。
当然,十万卡集群的真正考验还在后面。大规模集群的长期稳定运行、能效比的持续优化、软件生态的丰富程度,都需要时间来验证。但无论如何,从“有没有”到“好不好用”的跨越,已经迈出了最关键的第一步。当全国产的十万张加速卡在深圳的展台上整齐亮起指示灯,它照亮的不只是一个展厅,更是中国算力自主可控的未来。
来源:经济日报




[…] 供给侧的动作已经展开。就在不久前,全国产十万卡AI超集群正式点亮,标志着国产算力在超大规模集群组网能力上取得突破;与此同时,万P级算力集群也在多地加速落地。从芯片、服务器到集群组网,国产算力产业链正在补齐最后一块拼图。 […]