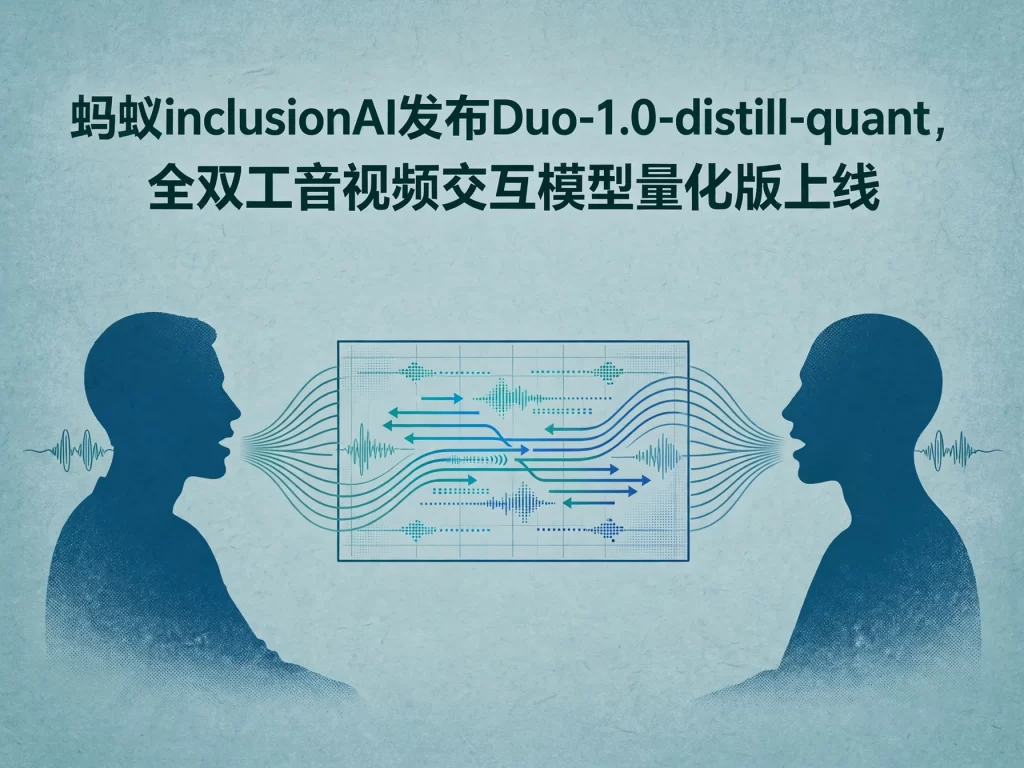
导语:蚂蚁旗下inclusionAI发布Duo-1.0-distill-quant,这是一款用于全双工音视频交互的模型,采用FP8量化与四步蒸馏。同系列的Duo-1.0-causal-base已于11月12日发布,开发者可以在Hugging Face上获取相关模型。
要理解这次发布的意义,先要明白全双工交互指的是什么。日常对话里,说话和倾听是同时进行的,一个人还没说完,另一个人可能已经点头、插话或者接过话题。传统的语音交互模型大多是轮流进行的,一方说完另一方再回应,中间总有一段等待。全双工模型的目标就是还原这种自然状态,让机器在听的同时也能说,在说的同时也能听,交互过程不再是一问一答的回合制。
Duo系列正是面向这个目标设计的。它处理的是音视频交互,也就是说,模型同时接收声音和画面两种信号。声音里有语气、语速和停顿,画面里有表情和动作,两路信号结合起来,模型对对话状态的判断会更完整。这种设计对应的是视频通话、虚拟助手、在线服务等场景,在这些场景里,只听声音或者只看画面都不够用。
这次发布的distill-quant版本,是在原有模型基础上做的轻量化。FP8量化是一种把模型参数用更低精度表示的方法,占用显存更少,推理速度更快;四步蒸馏则是把大模型的知识压缩到更小的结构里,用更少的步骤完成推理。两者结合,目标是在尽量保持交互能力的同时,把部署成本降下来。量化版本不是功能上的升级,而是落地形态上的调整,让同样的能力可以在更便宜的硬件上运行。
量化当然不是没有代价的。把参数精度从高位降到FP8,理论上会损失一部分表达能力,蒸馏的作用就是尽量把这种损失补回来,用更小的结构保留原模型的关键能力。实际效果如何,取决于蒸馏做得好不好,不能只看方法名字下结论。开发者拿到模型之后,可以在自己的场景里实测交互延迟、响应质量和稳定性,这些实测结果比发布时的描述更有参考价值。
同系列的Duo-1.0-causal-base已于11月12日发布,比量化版本早一天。两个版本一前一后出现,说明inclusionAI在以系列的方式推进Duo模型,先放出基础版本,再跟进量化版本。开发者可以在Hugging Face上获取该模型,相关页面由inclusionAI官方维护,The Deploy Log于2026年11月13日收录了这次发布。
从行业趋势看,全双工音视频模型正在从研究演示走向实际部署。早期的全双工模型对算力要求很高,能跑起来的场景有限,量化版本的出现,意味着这类模型开始考虑成本问题。成本降下来之后,能用它的场景才会变多,视频客服、实时翻译、远程协作这些对交互自然度要求高的应用,都有可能成为落地点。
需要注意的是,这次发布的信息主要来自inclusionAI在Hugging Face上的官方页面,尚未见到中文媒体的同题报道。因此本文以官方发布内容为准,没有引用中文媒体的报道细节。模型的实际交互效果如何,还需要开发者在真实场景中使用之后才能验证,量化带来的能力变化也需要实测数据来检验。
来源:inclusionAI、The Deploy Log
相关阅读
腾讯混元发布实时语音模型Hy Realtime,会说话还会唱歌