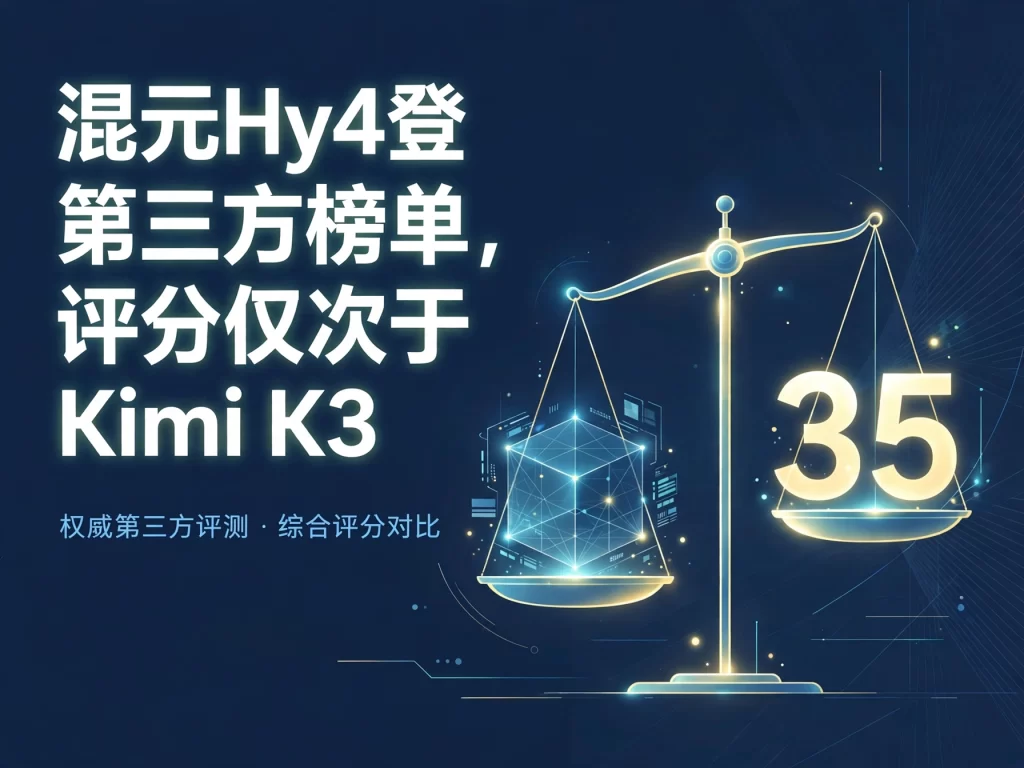
腾讯混元Hy4拿到一个可比较的坐标。11月7日,腾讯混元转发Artificial Analysis对Hy4的评测结果,按其Intelligence Index v5,Hy4得分为35,在中国实验室模型中仅次于Kimi K3。这条消息本身并不长,但它标志着一件事:国内大模型正在从各自发布会上的描述,走到可以并排比较的公开基准面前。对开发者来说,选型时少一点凭感觉,多一点可复核的数据,这正是第三方榜单的价值所在。
先看Hy4这款模型。11月4日,腾讯正式发布混元Hy4,总参数7700亿、每次推理仅激活490亿参数,是混元系列中首次具备图像识别能力、甚至能通过点击屏幕直接操作计算机的模型。发布之后,Hy4已在腾讯云和OpenRouter上线,开发者可以直接调用。Artificial Analysis的Intelligence Index是一套综合评测指数,覆盖多个任务维度的模型表现,v5是其最新版本。Hy4拿到35分,放在中国实验室模型的横向比较里,仅次于Kimi K3,这个位置说明Hy4的综合能力已经进入了国内第一梯队,至少在第三方评测的口径下是这样。
但榜单的意义也要放在正确的位置上理解。单个榜单当然不能替代完整的能力判断,尤其不同团队会针对不同任务取舍。有的模型擅长推理,有的擅长代码,有的擅长长文本,有的擅长多模态,一张榜单的综合分很难把这些差异完全摊开。更何况,不同榜单的测试集、权重与评分方法各不相同,同一个模型在不同榜单上的名次可能相差甚远。Hy4的35分,首先是一个可比较的坐标,而不是一句“谁强谁弱”的终审判决。对开发者而言,榜单的价值在于提供一把统一的尺子,而不是替你做决定。
把Hy4的榜单成绩放到最近一周的国产模型发布潮里看,画面会更完整。11月4日,月之暗面开放了Kimi K3.1 Pro的权重,总参数2.8万亿的模型登顶Agent Arena开放模型榜;11月5日,百度公开了ERNIE 5.5 Flash Base的权重,总参数280B,自评在30个基准测试中的24项领先同规模中国模型;11月7日,蚂蚁百灵发布Ling-3.2-flash,总参数560B,主打1M原生长上下文与自检恢复。短短几天,头部厂商接连把大模型推向开源社区,竞争的焦点已经从“参数多大”转向了“能力如何被第三方验证”。谁的分数经得起独立复核,谁的模型才真正站得住脚。
值得注意的是,这波榜单热背后,还有一个正在形成的共识:厂商自评与第三方评测正在分工。厂商发布时给出的基准成绩,往往是自己选的测试集、自己跑的分,难免有“报喜”的倾向。百度在ERNIE 5.5 Flash Base的发布中就坦言,自评对比的是同规模的开源基础模型,且尚未经过独立验证。第三方机构的价值,恰恰在于用同一套尺子量所有模型,让不同厂商的成绩可以并排比较。Hy4这次被Artificial Analysis测出35分,相当于接受了一次公开的“体检”,体检报告好不好是一回事,敢不敢公开体检是另一回事。
对腾讯来说,Hy4的榜单成绩还有一层商业含义。混元系列此前一直被认为在开源模型的第一梯队里稍显低调,这次拿到第三方榜单的中国第二,至少在传播层面补上了一块短板。而对整个行业来说,越来越多的模型愿意接受第三方评测,本身就是一个积极信号:当榜单成为常态,厂商的注意力会从发布会上的措辞,转向评测集上的真实表现。接下来值得观察的,是Hy4在更多榜单上的成绩,以及Kimi、百度、蚂蚁等厂商的模型是否会在同一套尺子下接受比较。当所有人都在同一张榜单上,竞争才真正开始。
来源:Artificial Analysis(晨启Tech 2026年11月7日科技简报整理)
相关阅读:腾讯混元Hy4正式版发布、Kimi K3.1 Pro登顶Agent Arena开放模型榜、百度开源ERNIE 5.5 Flash Base