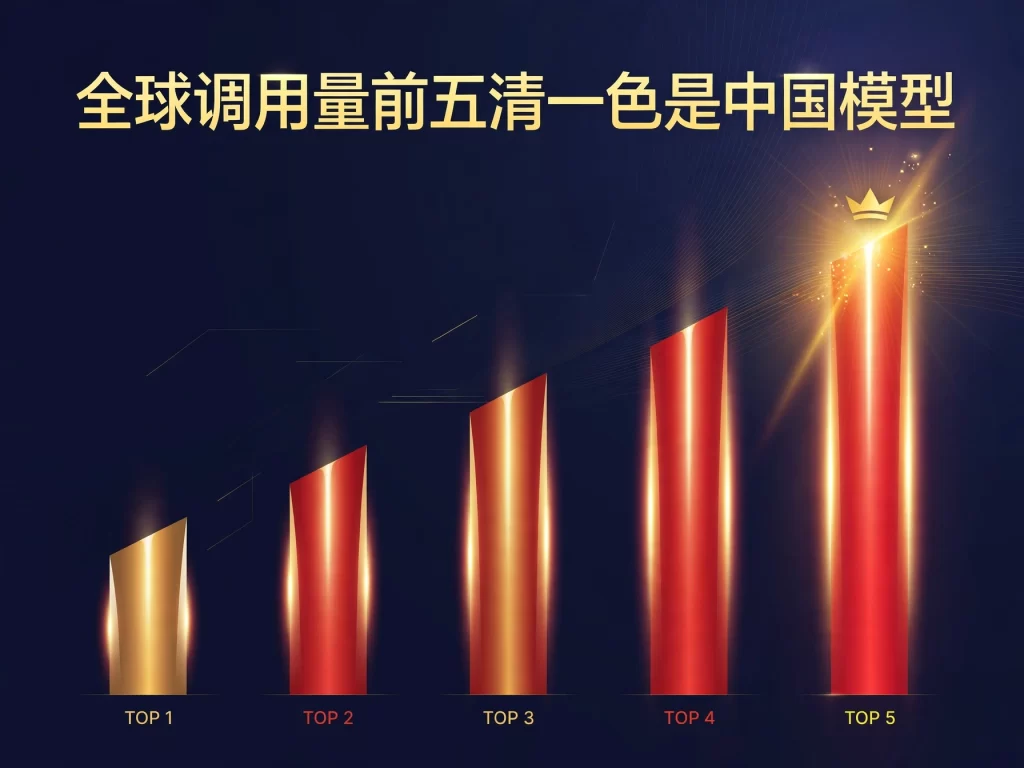
模型好不好,不只看榜单跑分,还要看开发者是不是真的在用。最新一周的调用数据给出了一个颇具分量的答案:全球调用量前五,清一色是中国模型。
这组数据来自OpenRouter,一个聚合了多种模型调用的开放平台。2026年10月19日至25日这一周,DeepSeek V4.1-Flash-1017的单周调用量达到33.6万亿Token,登顶全球第一。33.6万亿是一个难以直观想象的数字,换算成日常语言,相当于全球开发者在一周之内,通过这个平台向这一个模型发起了天文数字般的请求,而每一次请求背后,都可能是一次代码补全、一次文档问答、一次内容生成,或者一次智能体任务的执行。调用量登顶,意味着它不只是在评测里表现好,更是在真实工作流里被高频使用。
更值得注意的,是“前五清一色”这个整体格局。单个模型登顶可以归因于一次版本更新、一次价格调整或者一次热点事件,但前五名全部来自中国模型,则很难用偶然来解释。它说明中国模型群体已经形成了一种合力:不同厂商、不同定位的模型,在全球开发者的工具箱里同时占据了多个位置。开发者选择模型时考虑的因素很实际:能力够不够、价格合不合算、调用稳不稳定、生态好不好接入。当多个中国模型在这些维度上同时过关,前五的格局也就顺理成章。
DeepSeek V4.1-Flash-1017的名字本身也透露了定位信息。Flash一类模型通常主打速度与成本:响应快、价格低,适合高频、大批量的调用场景,比如智能体每一步的推理、代码助手的实时补全、客服与内容生产的批量任务。这类场景对单次调用的质量要求未必是最高,但对成本与速度极其敏感,差之毫厘,乘以亿万次调用就是巨大的成本差距。中国模型在这一层面的竞争力,很大程度上来自开源生态与高性价比路线的长期积累:模型权重开放,部署方式灵活,开发者可以自己托管、自己优化,不必被单一厂商的定价与接口绑定。
调用量数据还有一层含义,常常被忽略:它反映的是“用脚投票”的结果。跑分可以针对性优化,宣传可以放大单点优势,但调用量是开发者每天真金白银花出来的选择,是无数次小决策累积成的总账。一个模型被调用33.6万亿次,说明它已经嵌入了大量产品的生产链路,换掉它的成本正在变高;而前五全部来自中国,则说明这种嵌入不是孤例,而是一批中国模型共同进入了全球生产链路。这种渗透一旦形成,生态效应就会自我强化:用的人越多,相关的工具、教程、部署方案就越完善,新用户接入的门槛就越低。
当然,调用量也需要冷静看待。OpenRouter只是全球模型调用的一个窗口,不是全部市场,企业级私有化部署、厂商自有渠道的调用并不完全包含在内,单周数据也可能受到版本发布节奏的影响。前五的格局能否长期保持,取决于中国模型能否在下一代能力、长上下文、多模态与智能体等方向上持续跟进,而不只是在成本与速度上保持优势。但无论如何,这一周的数据已经改变了一个旧有的叙事:过去人们习惯于把中国模型看作追赶者,现在至少在开发者实际使用的层面,中国模型已经是全球舞台上的主角之一。
与此同时,11月2日至5日的世界互联网大会乌镇峰会将设“人工智能乌镇对话”,围绕全球人工智能开源生态构建展开交流。调用量前五的格局与乌镇对话的议题恰好呼应:开源生态的竞争,最终要落到谁的模型真正被用起来、谁的生态真正跑起来。33.6万亿Token的一周,既是中国模型的一次成绩单,也是全球开源生态力量对比的一次注脚。接下来,值得看的是这些调用量能否转化为更持久的生态优势,以及中国模型在下一轮能力竞赛中,能否把“用得多”变成“用得深”。
来源:新浪财经