


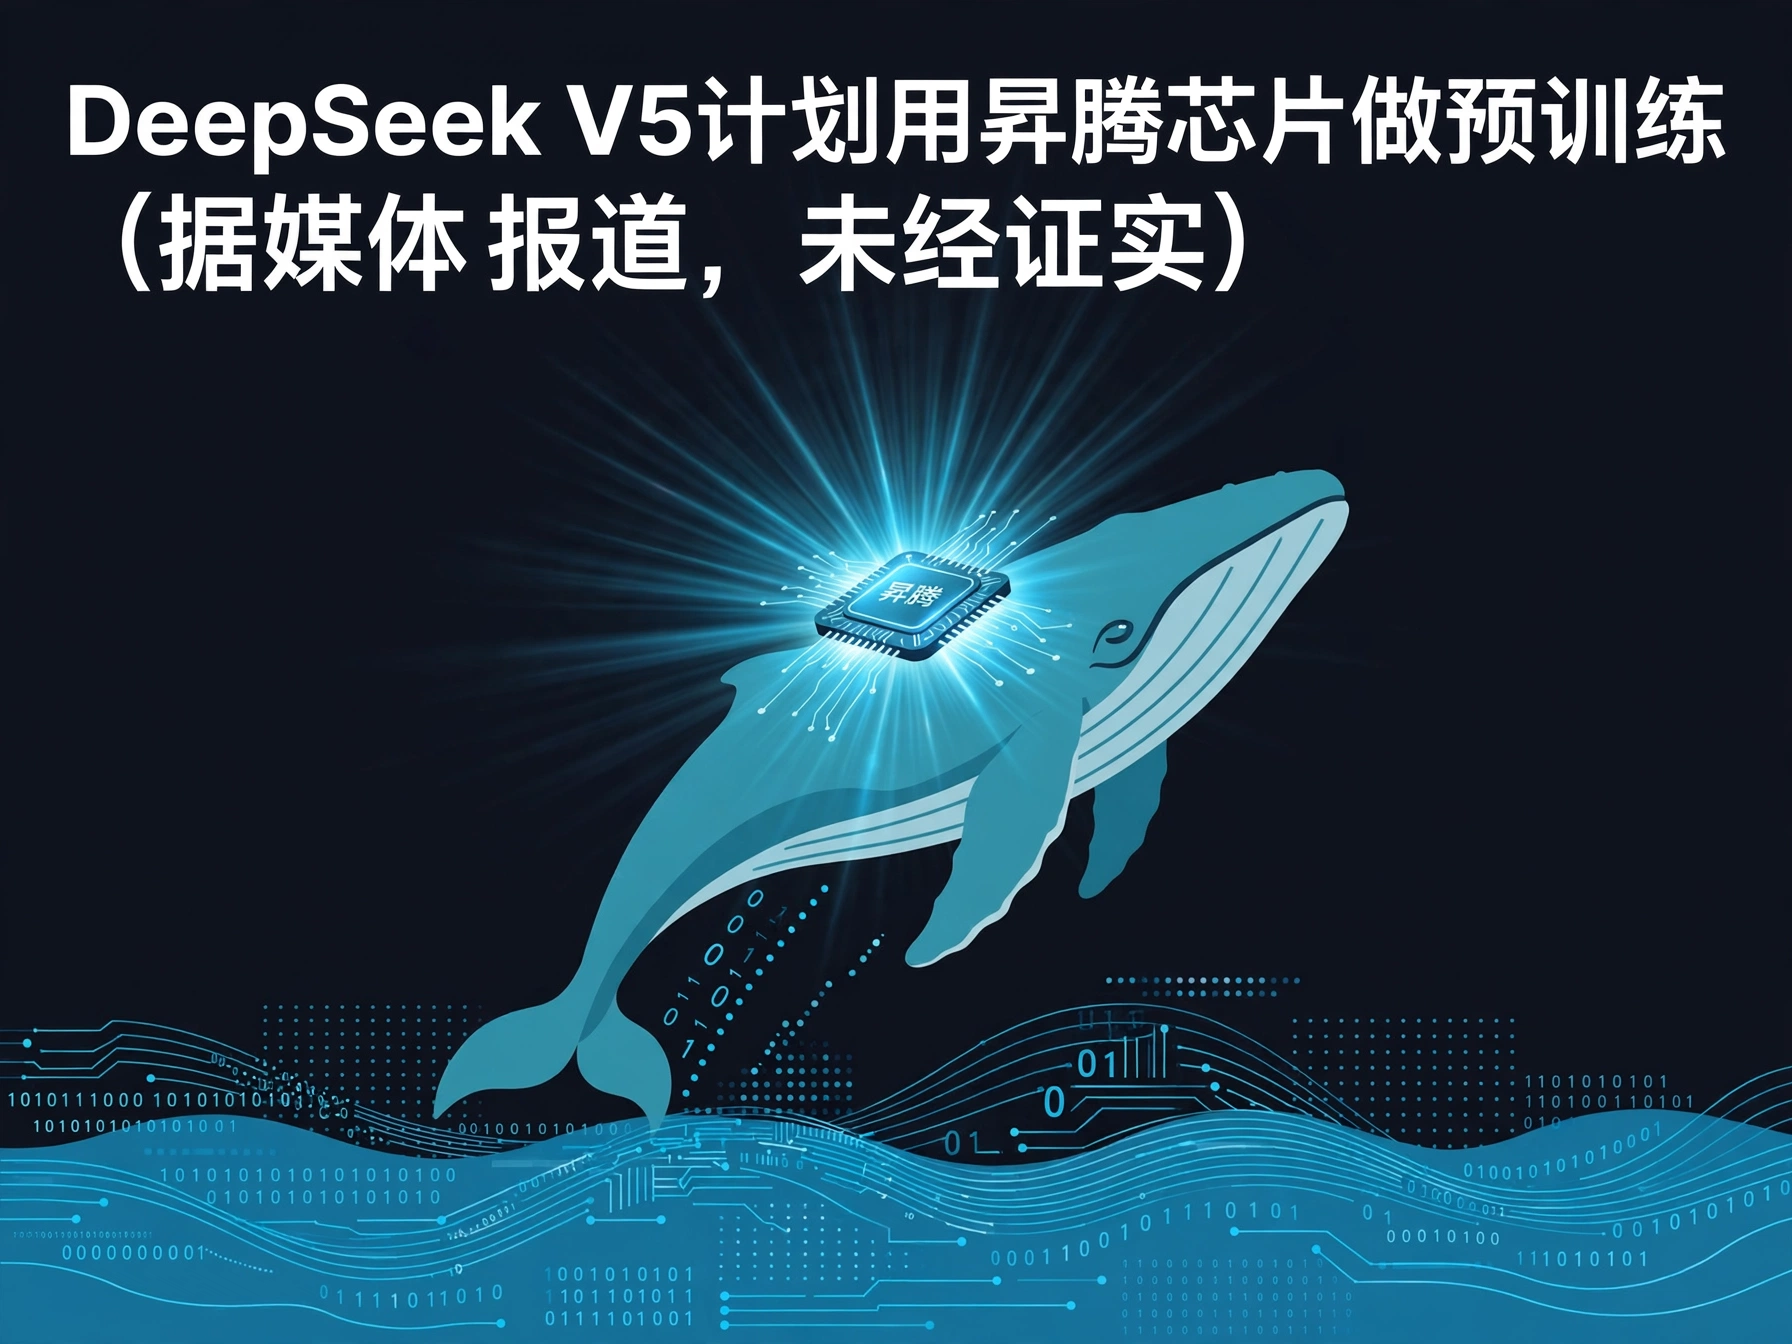
据多名产业链人士透露,DeepSeek下一代大模型V5计划基于昇腾芯片进行预训练。此前昇腾主要用于DeepSeek大模型的推理任务,而非从零开始的基础预训练。相关消息尚未得到官方证实。
据多名产业链人士透露,DeepSeek的下一代大模型V5,计划基于昇腾芯片进行预训练。消息一出,立刻在AI圈和芯片圈同时激起了涟漪。需要先划清界限:这是一则来自产业链渠道的爆料,DeepSeek官方尚未证实,相关细节仍有变数。但即便只把它当作一则传闻,它所指向的趋势本身,就值得认真拆解。
理解这则传闻的分量,要先搞清楚“预训练”和“推理”的区别。推理是模型建成之后拿来用的阶段,算力需求相对分散、容错率较高;预训练则是从零开始“教”模型的过程,需要成千上万张卡长时间稳定协同,对芯片的互联带宽、通信效率和软件栈成熟度都提出了极高要求。此前,昇腾芯片在DeepSeek的体系里主要承担推理任务,而预训练一直被认为是国产芯片最难啃的硬骨头。如果V5真的把预训练搬上昇腾,那就意味着国产芯片第一次要正面挑战大模型训练的最核心环节。
为什么是现在?背景并不难找。一方面,外部算力供给的不确定性在上升,高端芯片的获取成本与合规风险都在推高“把训练放在国产芯片上”的战略价值;另一方面,昇腾的软件生态在过去两年的推理大规模落地中得到了持续打磨,通信库、算子库和训练框架的成熟度都在爬坡。从“能跑推理”到“敢做预训练”,中间隔着的正是这段生态补课的过程。产业链人士选择在这个时间点放出消息,很可能意味着相关验证已经进行到了可以对外讲的阶段。
当然,冷静的声音同样必要。预训练不是换个芯片就能平移的活:从数据并行、张量并行到混合专家架构的通信优化,从训练稳定性到断点续训的容错机制,每一个环节都需要针对硬件重新调校。即便V5真的启动昇腾预训练,初期也大概率是“混合路线”——部分环节先行验证、逐步扩大比例,而非一夜之间全面切换。历史上,任何一家厂商挑战训练硬件的迁移,都走过类似的渐进过程。
还有一层更值得玩味的信号:这则传闻的主角双方,恰好是中国AI生态里最具象征意义的两个名字——一个是凭借低成本、高性能路线改写全球大模型竞争格局的DeepSeek,另一个是国产算力自主化的旗手昇腾。如果两者在预训练环节真正合流,其意义将超出单一产品的范畴,成为中国AI“模型+算力”自主闭环的一次关键验证。当然,在官方证实之前,这一切仍应被标注为“据媒体报道,未经证实”。
对行业观察者来说,接下来的验证信号很清晰:DeepSeek是否会在公开场合提及训练算力的变化,昇腾生态是否会出现针对V5架构的公开适配,以及V5正式发布时技术报告里关于训练基础设施的表述。在此之前,不妨把这则传闻当作一个观察窗口,而不是既定事实。
来源:产业链消息(据媒体报道,未经证实)
相关阅读:国产芯片的瓶颈:不缺技术与资金,缺的是时间和耐心;智谱 GLM-Legal 法律专用开源模型登顶 Harvey LAB 与 LegalBench 双榜







[…] 值得注意的是,元环智能的团队平均年龄只有约22岁,成员多来自清华、北大等顶尖高校,成立于2026年5月。团队自主研发的模型训练直觉测试基准“Architecture IQ”近期也会发布,用来评估大模型和人类研究员对模型训练的直觉水平。按照公司的规划,明年将推出通用的元模型1.0,不限定场景,去生成适配各个垂直领域的专用模型。 […]
[…] 相关阅读:DeepSeek V5计划用昇腾芯片做预训练、DeepSeek登顶全球第一、Kimi K3.1 Pro登顶Agent Arena开放模型榜 […]