


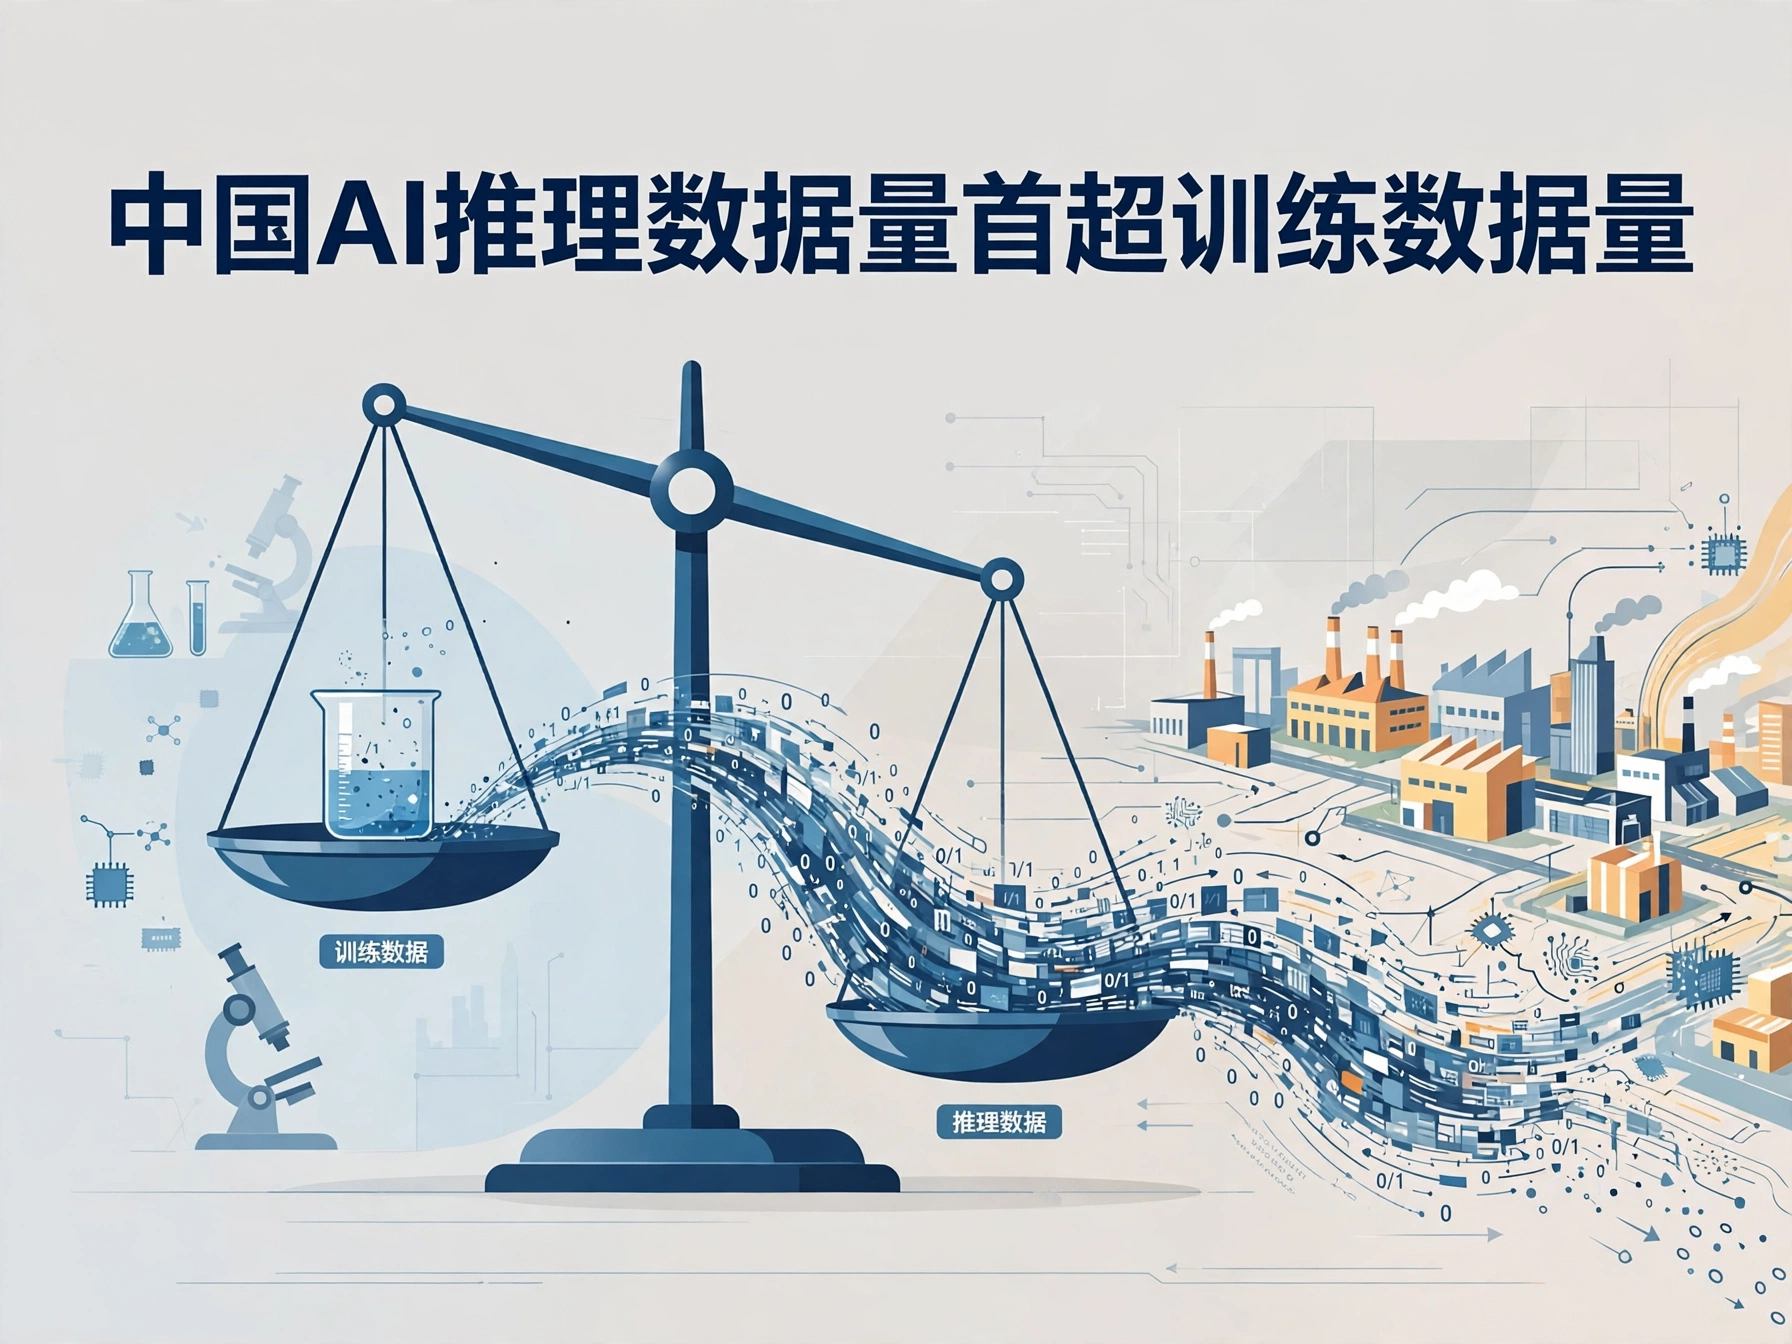
一个标志性的拐点已经出现。10月31日,中国电子信息产业发展研究院发布的《新域新质创新发展十大趋势》显示,我国人工智能推理数据量首次超过训练数据量。数据显示,截至2026年6月,日均词元调用量超过175万亿,相比2024年年初增长1000多倍。这意味着,中国人工智能正在从“喂模型”的实验室阶段,全面转入“用模型”的产业落地阶段。
训练与推理,是大模型生命线上的两个阶段。训练像是上学,需要海量数据和算力把知识“喂”给模型;推理则是工作,是模型在真实场景中回答问题、处理任务、创造价值。过去几年,公众视线大多停留在训练一侧:参数规模、算力集群、训练数据的量级,成为衡量一家厂商实力的标尺。而推理数据量超过训练数据量,说明模型已经大规模走出实验室,被千行百业真正用了起来,AI的价值重心正在从“造模型”转向“用模型”。
数字本身颇具冲击力。日均词元调用量超过175万亿,相比2024年年初增长1000多倍,这样的增速在产业史上并不多见。词元是模型理解和生成语言的基本单位,调用量的爆发,直接对应着应用场景的爆发:客服对话、代码辅助、内容生成、工业质检、政务办理……每一次调用背后,都是一次真实需求。更值得注意的是顶尖大模型的迭代周期已经从过去的几个月压缩到几周甚至几天,模型越好用,用的人就越多,用的越多,反馈回来的数据和需求又推动模型更快迭代,一个正向循环正在形成。
这份报告还透露了产业落地的广度。智能制造是推动人工智能加快规模化应用的重要场景,随着“人工智能+制造”行动深入实施,我国已累计建成500多家卓越级智能工厂,覆盖31个省(区、市),涵盖超过80%的制造业行业大类。国产算力、大模型已在钢铁、汽车等20个行业落地1000多个应用场景,推动个性化定制、全生命周期服务等新模式不断拓展。换句话说,AI不再是少数互联网公司的点缀,而是正在变成制造业升级的基础设施。
拐点的出现,也对产业提出了新的要求。推理规模上去之后,成本、能效和稳定性成为更现实的考验:每一次调用都要消耗算力,如何用更低的成本提供更快的响应,直接决定了应用的普及速度。这也是国产芯片、推理优化技术和一体机市场近期备受关注的原因之一——当推理成为主战场,谁能把“用模型”这件事做得更便宜、更可靠,谁就能在下一阶段占得先机。与此同时,推理数据的爆发也意味着数据安全与合规的重要性进一步上升,如何在规模化调用中守住隐私与安全的底线,同样不容忽视。
从更宏观的视角看,推理超越训练是中国AI发展阶段的一次“成人礼”。它标志着过去几年在模型、算力和人才上的投入开始转化为规模化的产业回报,也意味着竞争的焦点正在从“谁的模型更大”转向“谁的模型更好用、更便宜、更贴近场景”。对于企业而言,下一步的关键不再是追逐参数纪录,而是找到模型与自身业务结合最深的那个点;对于整个产业而言,推理时代的比拼才刚刚开始,而中国已经站在了规模化应用的前排。
相关阅读:DeepSeek V5:更强模型,成本却不到同类四分之一;智元发布机器人边干边进化的Genie Master
文末来源:央视新闻客户端、中国电子信息产业发展研究院《新域新质创新发展十大趋势》







[…] 相关阅读:中国AI推理数据量首超训练数据量;小米开源硬件HachimoDock亮相,150元可复刻万能AI桌宠 […]
[…] 相关阅读:中国AI推理数据量首超训练数据量;DeepSeek发布全新Agent架构“Super-agent”,让AI调度AI […]
[…] 相关阅读:智元发布机器人边干边进化的Genie Master;中国AI推理数据量首超训练数据量 […]