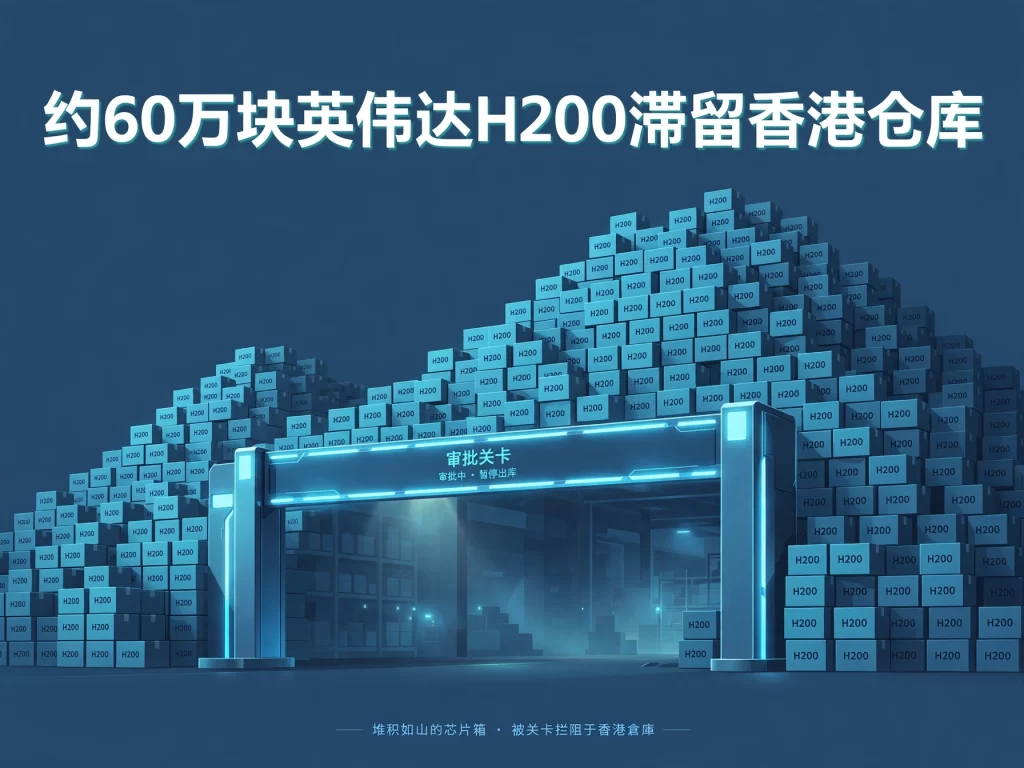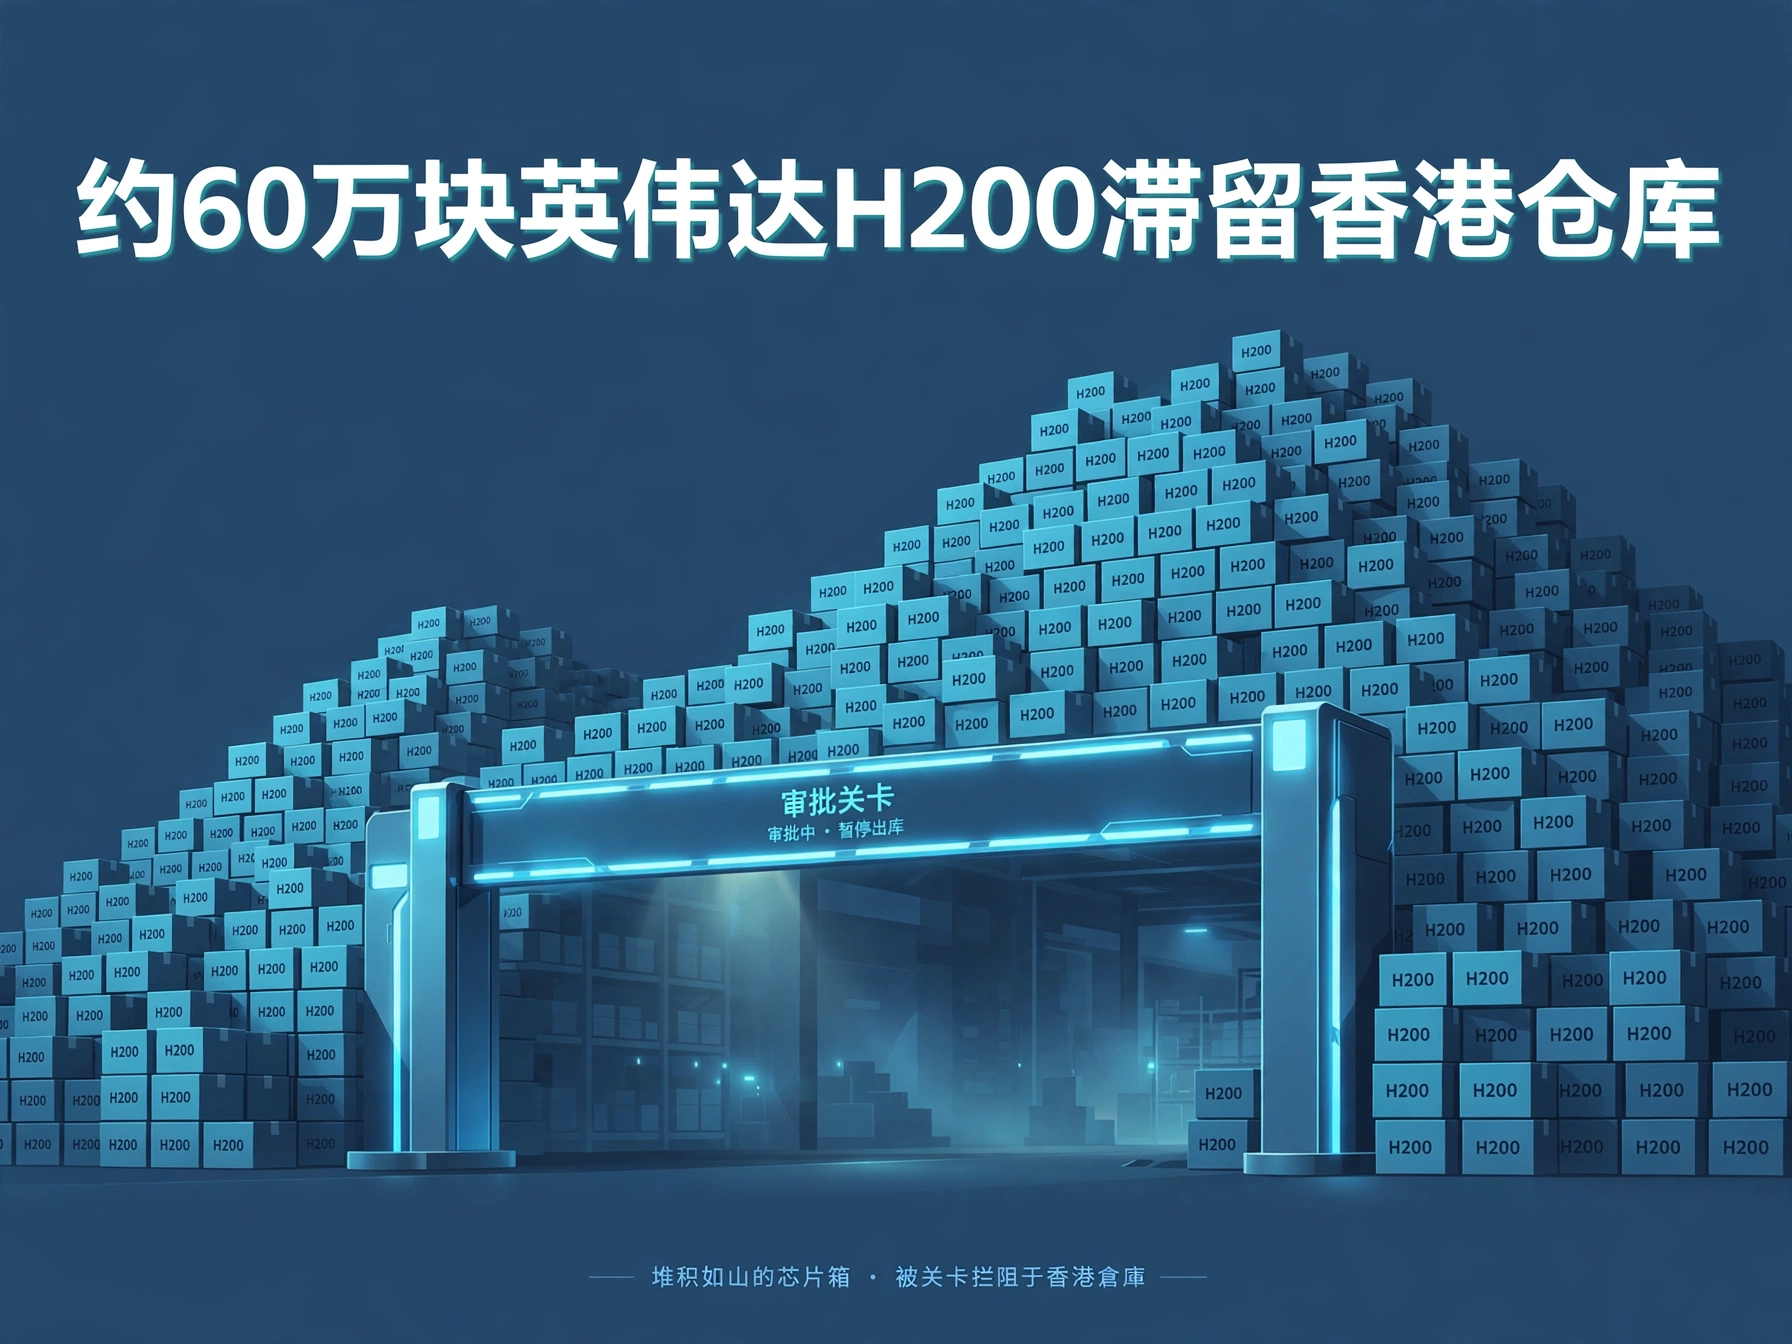
香港仓库里躺着约60万块H200,北京的进口许可却仍按每家科技巨头约1万块的节奏发放。据路透社11月7日报道,约60万块英伟达H200芯片滞留香港仓库,受阻的一方是北京而非华盛顿。一边是对算力短缺的焦虑,一边是大量现货卡在仓库,这个画面很有讽刺意味,也把算力供给最别扭的一面照了出来:芯片不是只有买得到和买不到两种状态,能否进来、怎么进来、进来后给谁用,同样决定模型竞赛的速度。
先算一笔简单的账。60万块芯片躺在仓库里,按每家科技巨头约1万块的规模小批量发放,意味着即便只分给少数几家头部公司,全部消化也需要相当长的时间。而对需要成规模训练和推理集群的公司来说,分批到货会直接影响集群规划、利用率和产品节奏。一个大模型训练任务,往往需要成千上万块芯片组成一个集群协同工作,缺一块都可能拖慢整体进度。如果芯片分几个月陆续到货,训练计划就得跟着审批节奏反复调整,推理服务的扩容也要一再推迟。芯片在仓库里不等于算力已经在手里,账面上的可得性与工程上的可用性,中间隔着一层很现实的审批流程。
这条消息的另一层含义在于,瓶颈的位置变了。过去几年,AI芯片的短缺更多被归因于供给端:产能不够、良率爬坡、订单排队。如今H200的现货已经摆在仓库里,卡住的却是进口许可的节奏。这说明算力竞赛的约束条件正在从“造不造得出来”扩展到“让不让进来、进来的速度有多快”。对中国的大模型公司来说,这意味着即便手里有钱、仓库里有货,算力的扩张速度仍然受制于审批的阀门。模型可以按周发版本,基础设施却按季度甚至按年移动,两边的节奏差,正在变成行业共同的焦虑。
从产业的应对来看,分批到货正在倒逼两条路。一条是国产替代的加速。多名产业链人士透露,DeepSeek下一代大模型V5计划基于昇腾芯片进行预训练,此前昇腾主要用于DeepSeek大模型的推理任务,而非从零开始的基础预训练。如果这一计划落地,意味着国产芯片正在从推理环节向训练环节渗透,算力的自主可控不再只是一句口号。另一条是国产芯片公司的融资与扩产:快手系芯片公司凌川科技11月4日完成10亿元B轮融资,其基于全国产3D堆叠技术的芯片今年4月完成流片、近日回片,预计明年实现规模出货;存算一体芯片企业后摩智能11月4日完成数十亿元B轮融资,M50芯片量产不到一年已获150多个产品定点。资本正在用真金白银押注国产算力的补位能力。
但国产替代不是一朝一夕的事。训练大模型需要的不仅是芯片本身,还有与之配套的软件栈、互联方案、运维经验,以及经过多轮大模型训练验证过的稳定性。H200滞留仓库的消息,恰恰说明即便在国产芯片加速追赶的当下,头部厂商对这款成熟产品的需求依然旺盛。短期内,审批节奏决定了头部公司能拿到多少算力;中长期,国产芯片的成熟速度决定了这种依赖能维持多久。两条线同时在跑,谁先到终点,谁就能掌握主动权。
对市场来说,60万块这个数字本身就是一个信号。它说明供给端并不缺货,缺的是流通的顺畅度。也正因如此,单纯盯着GPU的标价已经不够了,真正影响训练和推理扩张速度的,常常是那条看不见的审批与部署链路。接下来值得观察的,是许可发放的节奏会不会加快,滞留的芯片多久能进入数据中心,以及国产芯片在训练环节的验证进展。这三件事的答案,将共同决定中国大模型公司未来几个季度的算力账本。
来源:路透社(晨启Tech 2026年11月7日科技简报整理)
相关阅读:凌川科技完成10亿元B轮融资、后摩智能完成数十亿元B轮融资、DeepSeek V5计划用昇腾芯片做预训练