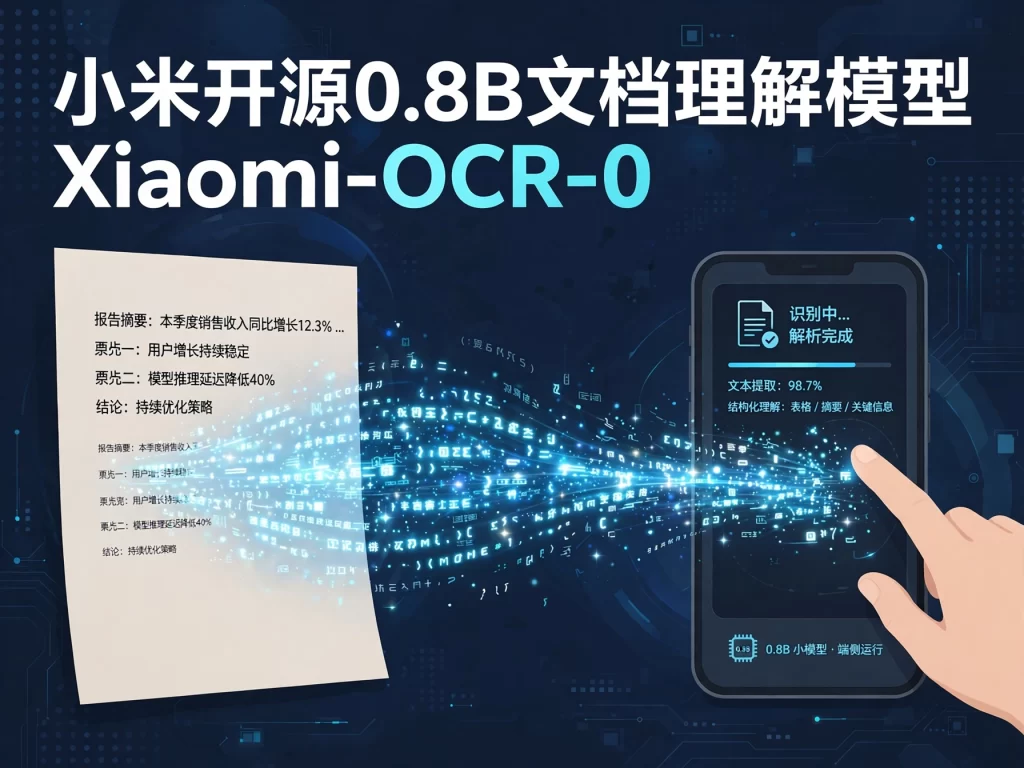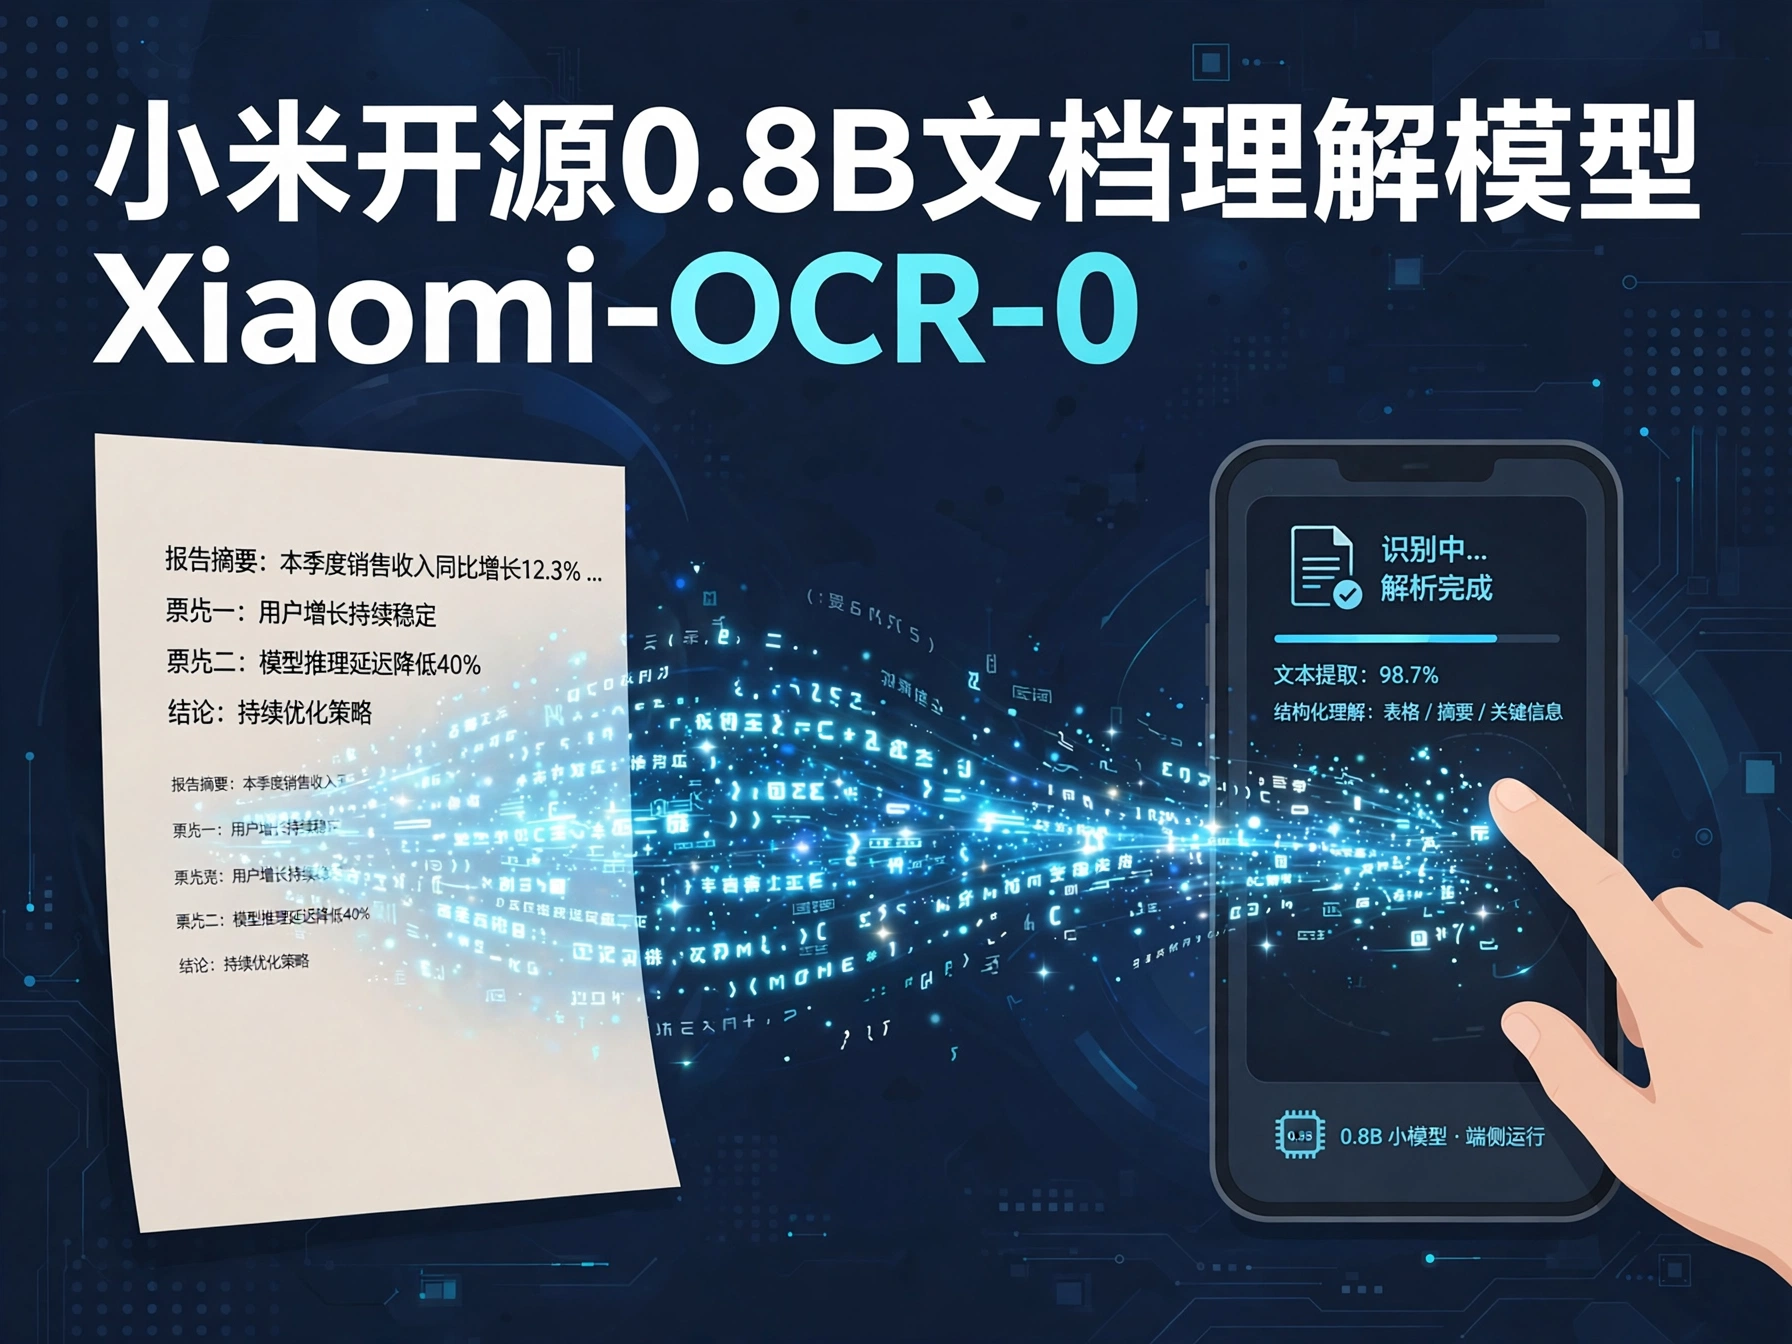
小模型正在办大事。小米开源的0.8B文档理解模型Xiaomi-OCR-0近日受到关注,相关技术正融入超级小爱的高频识屏场景,做文档理解的底座。在综合文档解析基准上,它在1B以下模型中排名第一。参数只有0.8B,却能在文档理解上拿下同量级第一,这件事本身就值得细看。
文档理解听起来不起眼,却是AI落地的关键一环。生活里处处是文档:合同、发票、报表、说明书、证件照片,手机识屏、拍照翻译、文件归档,背后都需要先把图片里的文字和版式“读懂”,再谈理解和处理。过去,这类任务要么靠传统OCR加规则,要么靠动辄几十亿参数的大模型,前者不够聪明,后者不够轻便。Xiaomi-OCR-0走的是中间路线:参数控制在0.8B,却专门为文档理解优化,力求在手机端也能跑得动、跑得准。
“在1B以下模型中排名第一”这个成绩,关键在于“1B以下”这个限定。它说明的不是绝对性能的天下第一,而是效率与效果的平衡:在同等轻量级选手中,它是最能打的一个。这种定位恰恰对应了真实需求——手机识屏是高频场景,用户希望点一下就出结果,不能忍受漫长的等待和云端往返;端侧小模型响应快、成本低、隐私性好,天然适合这类任务。把文档理解的底座做轻、做专,正是超级小爱这类助手体验升级的前提。
小米把这项技术与超级小爱的高频识屏场景结合,也透露了大厂布局端侧AI的思路:不是把所有能力都堆到云端大模型上,而是让合适的模型待在合适的位置。识屏、翻译、摘要这类高频轻任务由端侧小模型就近处理,复杂推理再交给云端大模型,分工协作之下,用户体验更流畅,成本也更可控。随着手机芯片端侧算力的提升,这种“端云协同”的分工只会越来越普遍,而专精的小模型正是其中的关键零件。
开源同样是这则消息的重要看点。小米把Xiaomi-OCR-0公开,意味着中小开发者和研究团队可以直接使用、测试、改进这个模型,而不必重复投入训练成本。对于文档处理类应用的创业者来说,一个现成的、经过基准验证的轻量模型,能显著降低起步门槛;对于学术界而言,开源模型也为文档理解方向的研究提供了可复现的基线。开源生态的每一次扩容,都会让后来者的路好走一分。
当然,小参数模型也有其边界。0.8B的体量决定了它在处理复杂版式、模糊图像、专业领域文档时,仍可能出现识别错误或理解偏差;基准第一也不等于在所有真实场景中都表现最优。真实世界的文档千奇百怪,手写、印章、表格嵌套、低质量扫描都是常态,模型能否在这些“脏数据”面前保持稳定,才是决定其商业价值的关键。接下来的观察点,是Xiaomi-OCR-0在超级小爱实际场景中的表现,以及开源社区围绕它长出的应用生态。
从更广的趋势看,Xiaomi-OCR-0的出现与今年以来“小模型崛起”的潮流同频:当大模型竞赛逐渐见顶,业界开始重新审视性价比——不是所有任务都需要巨无霸,有些任务恰恰需要又小又专的选手。文档理解只是其中一个缩影,未来还会有更多垂直场景迎来自己的“小而美”模型。对用户而言,这意味着AI能力将更自然地嵌入日常工具:识屏更快、翻译更准、文件整理更省心,而这些体验的改善,往往来自像Xiaomi-OCR-0这样不起眼却扎实的进步。
相关阅读:DeepSeek发布全新Agent架构“Super-agent”,让AI调度AI;中国AI推理数据量首超训练数据量
文末来源:新浪科技