


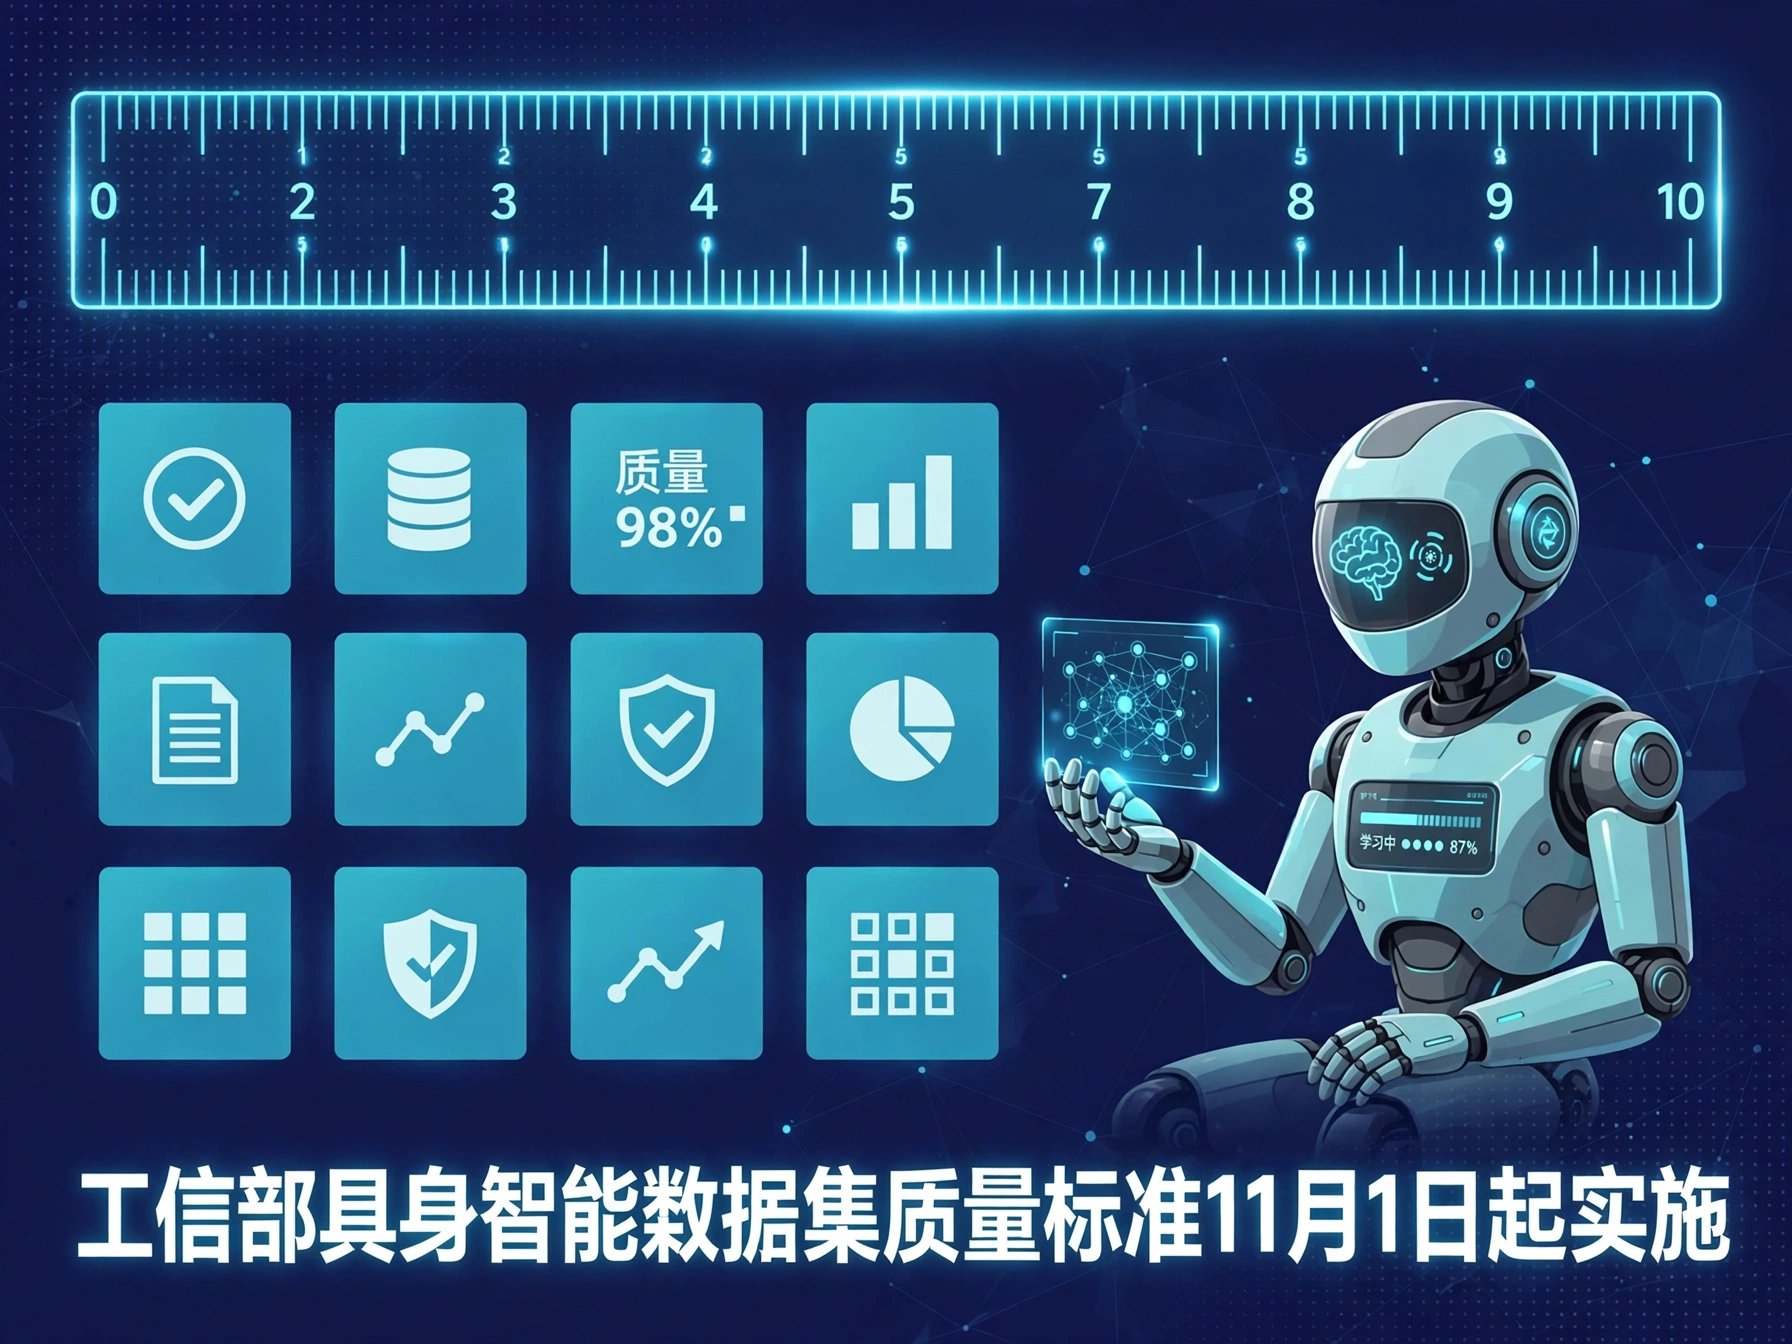
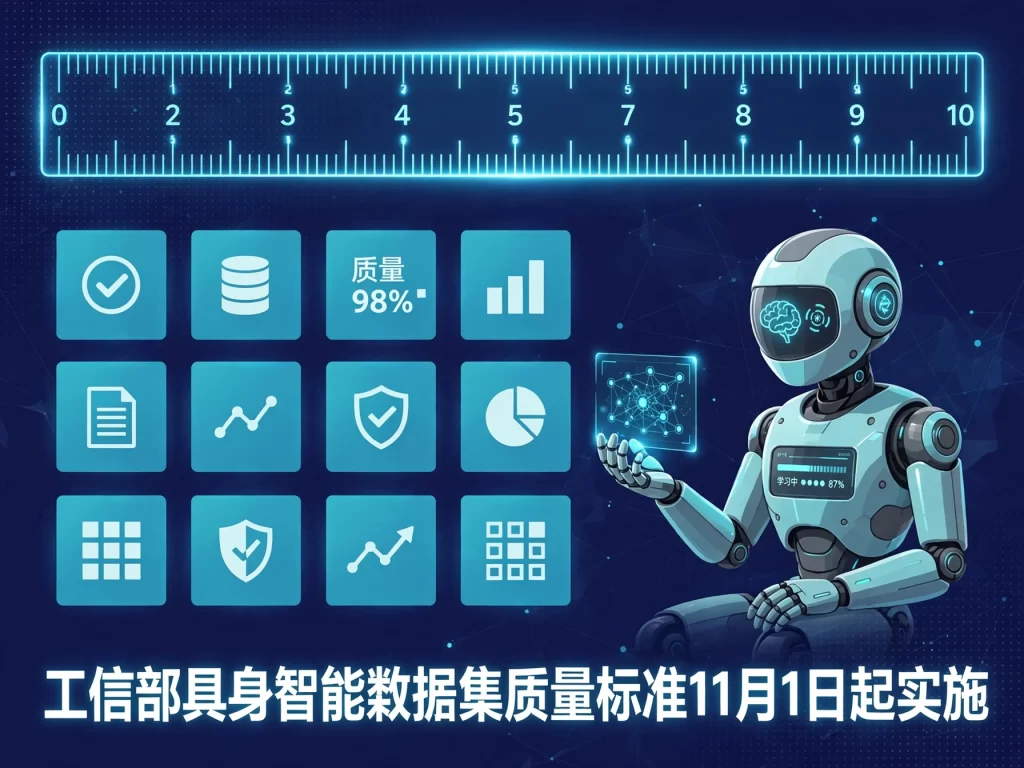
具身智能的数据,终于有了国家标准。《人工智能关键基础技术具身智能数据集质量要求及评价方法》由工业和信息化部批准发布,2026年11月1日起正式实施。这项标准由中国信息通信研究院联合行业40余家单位起草编制。数据被视为具身智能的“燃料”,这把标尺的出现,意味着行业开始从野蛮生长走向规范发展。
具身智能有一个被反复提及的共识:数据决定上限。机器人不像聊天机器人那样可以从互联网上海量文本中学习,它的“经验”来自真实世界的操作数据——如何抓握、如何行走、如何应对突发情况,每一次有效的数据采集都需要真机、真场地、真时间,成本高昂。也正因为如此,数据的质量参差不齐成为行业痛点:采集标准不一、标注口径各异、数据难以复用,同一个任务在不同团队手里可能得出完全不同的训练效果。标准的出台,首先就是要终结这种“各说各话”的状态。
从标准本身看,它围绕“质量要求及评价方法”展开,覆盖数据集建设与评价的关键环节。虽然具体条文需要从业者逐条对照,但方向是明确的:给数据的采集、标注、管理和评价立规矩,让数据集从“能用”走向“好用、可信、可用”。由中国信通院牵头、40余家单位共同起草的编制阵容,也说明这不是某一家企业的内部规范,而是行业层面的共识结晶,覆盖面和权威性都有保障。
时间点同样值得注意。2026年,百万小时的数据产能被视为企业研发模型的硬性门槛,具身智能正沿着大模型“大力出奇迹”的思路加速验证数据对模型的提升作用。在这个节骨眼上发布质量标准,相当于在行业踩油门的同时装上了仪表盘和交规:既要鼓励企业扩大数据产能,也要防止低质量数据以量取胜、劣币驱逐良币。对于正在布局具身智能的企业而言,标准既是约束,也是参照——按标准建设的数据资产,未来在交易、合作、评估中都会更值钱。
标准的实施还会对产业链上下游产生连锁影响。上游的数据采集与标注服务商将迎来统一的服务规范,竞争从价格战转向质量战;中游的模型研发团队可以更放心地采购和复用外部数据,训练效率有望提升;下游的应用方则多了一把衡量供应商数据能力的尺子。长远看,数据标准的统一还可能催生数据流通市场:当不同来源的数据可以用同一套语言描述和评价,跨企业、跨机构的数据协作才真正具备可操作性。
当然,标准从纸面落到车间还有一段路要走。评价方法是否可操作、执行成本是否可承受、中小企业能否跟上节奏,都是实施过程中需要回答的问题。标准制定者接下来的工作,是通过试点、认证和行业反馈不断打磨细则,让标准既有约束力又不至于成为创新的绊脚石。历史上,每一项基础标准的落地都经历过类似的磨合期,关键在于标准能否跟上技术演进的速度,及时修订、保持生命力。
对中国具身智能产业而言,这项标准的意义不止于规范本身。它释放了一个信号:行业正在从“讲故事”转向“拼内功”,数据的质量、规模和合规性将成为下一阶段竞争的核心变量。谁先按标准把数据资产做扎实,谁就可能在机器人规模化落地的竞赛中占得先手。11月1日这个实施日,或许会成为回望时值得标记的节点——具身智能的数据时代,从此有了统一的度量衡。
相关阅读:智元发布机器人边干边进化的Genie Master;中国AI推理数据量首超训练数据量
文末来源:观点网、工业和信息化部





[…] 相关阅读:工信部具身智能数据集质量标准11月1日起实施;智元CEL让96台机器人互学经验,具身智能迎来“群体学习”范式 […]